Цена за токен обманчива: сколько на самом деле стоит узбекский язык для ИИ
Компании, которые запускают ИИ-продукты на узбекском, выбирают модель по цене за миллион токенов. Исследование Gorgona AI показывает, что эта цифра не говорит главного: сколько будет стоить их собственный текст. Узбекский обходится в 1,55–2,17 раза дороже английского у всех крупнейших провайдеров, а разница между моделями с одинаковым прайсом достигает 1,7 раза.
Главная цифра прайса, которая ничего не обещает
Цена за миллион токенов стала для рынка тем же, чем цена за литр для бензина: по ней сравнивают поставщиков, на ней строят юнит-экономику. Для англоязычного продукта этого действительно достаточно. Для узбекоязычного нет.
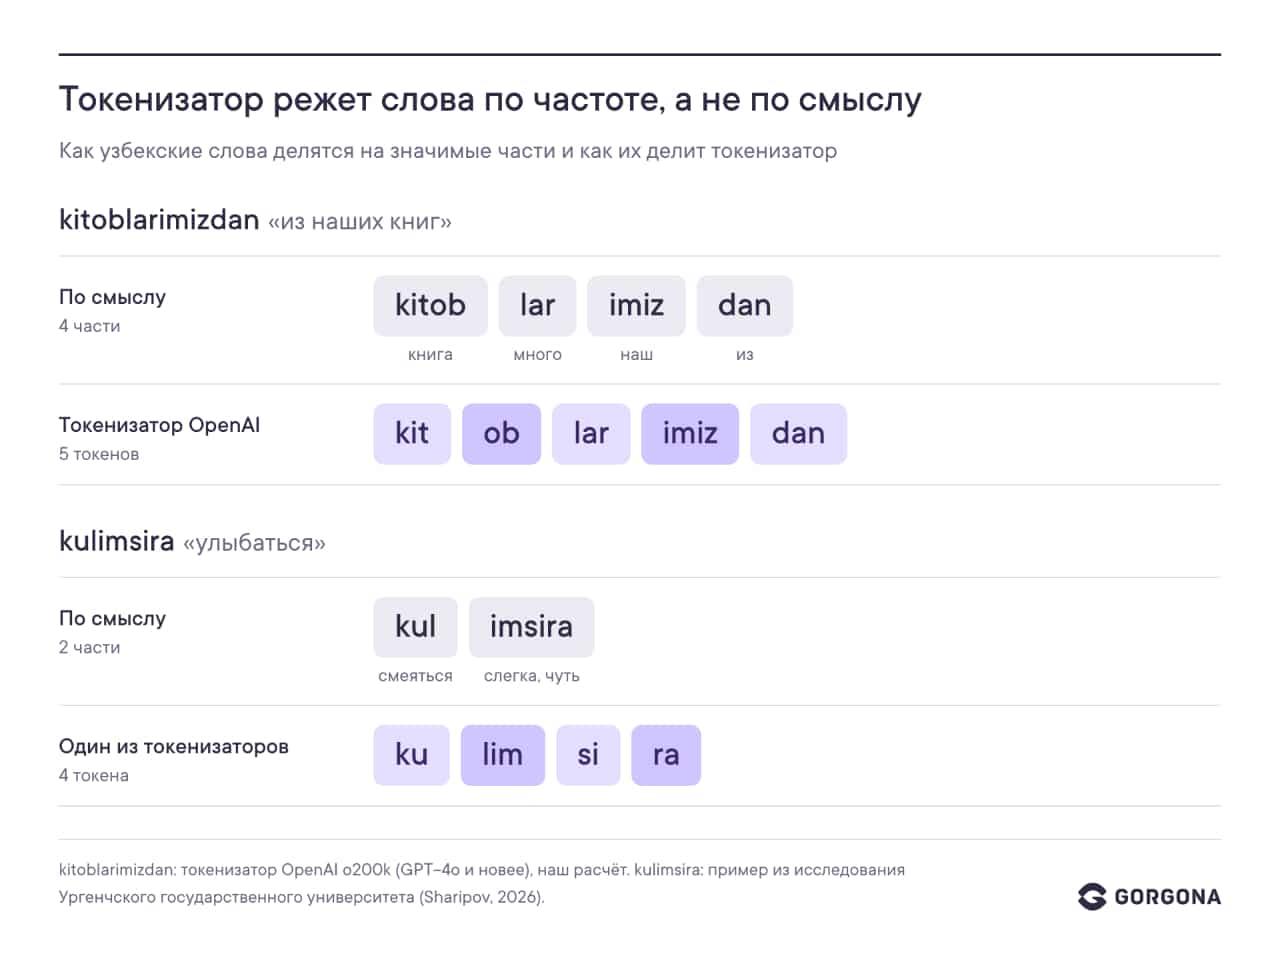
Причина в том, что провайдеры берут единый тариф за токен для всех языков, а вот число токенов на один и тот же смысл разное. Токенизатор, программа, которая режет текст на фрагменты перед обработкой, обучен в основном на английском. Узбекские слова, длинные и собранные из цепочек аффиксов, он разбивает на большее число частей. Клиент платит за каждую.
Как считали
Gorgona AI измерила надбавку за узбекский на 1337 параллельных текстах и 15 токенизаторах. Для Claude и Gemini токены считали официальными методами провайдеров, без посредников, так же, как их считает биллинг. Подсчёт Claude сверили с оплаченными токенами на реальных запросах, подсчет OpenAI с официальным методом на 80 текстах. Затем выводы проверили на 7808 реальных запросах к двум моделям. Авторы исследования подчеркивают, что качество ответов не подвергалось проверке. Эксперты Gorgona AI указывают на возможность рассмотрения этого параметра как следующего направления для анализа.
Что получилось
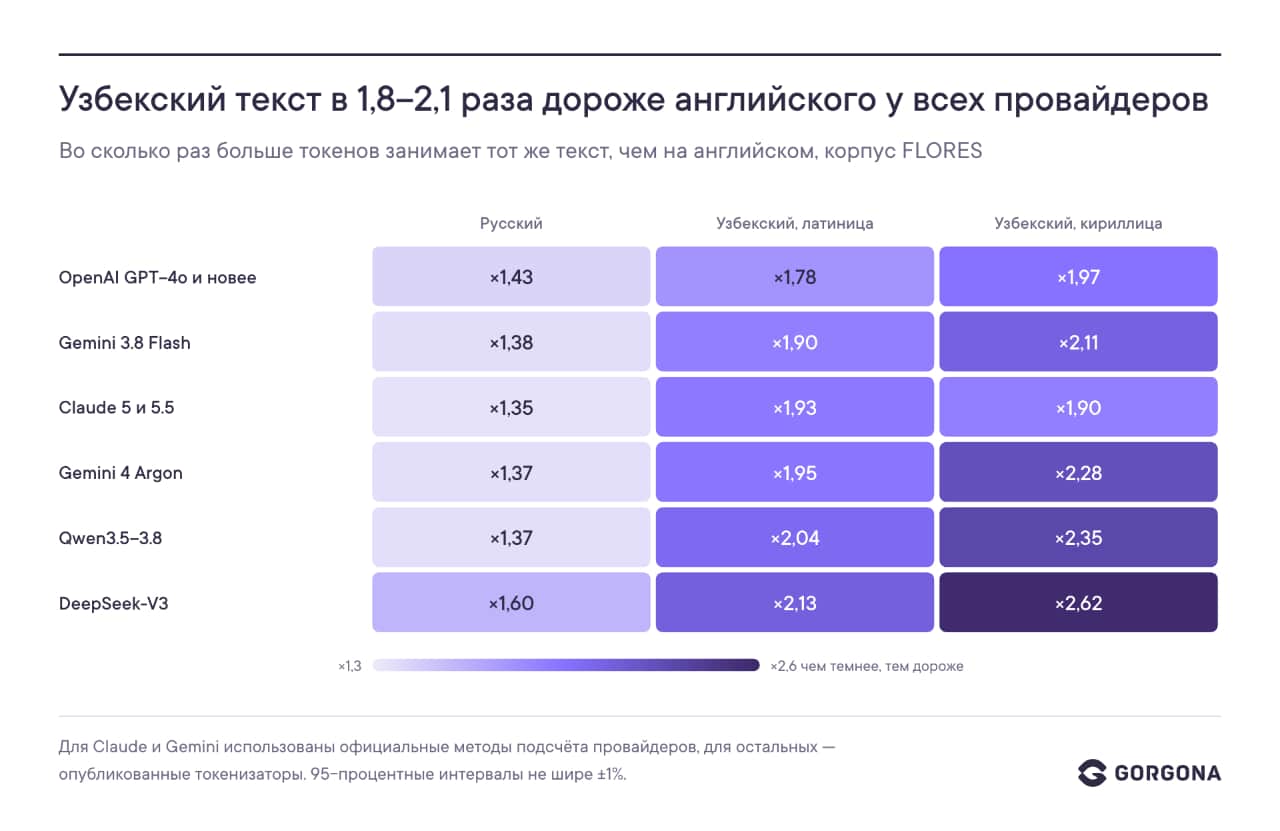
Надбавка к английскому. Узбекский текст на латинице занимает в 1,55–2,17 раза больше токенов у всех пяти провайдеров: OpenAI, Anthropic, Google, Qwen и DeepSeek. Ближе к нижней границе тексты, изначально написанные по-узбекски, ближе к верхней переводы с английского. Единой цифры для узбекского не существует, поэтому реалистичную оценку для своего продукта лучше искать внутри этого диапазона.
Надбавка к русскому. Тем, кто считал экономику по русскоязычным тестам, тоже стоит пересчитать: узбекский дороже русского в 1,24–1,54 раза в зависимости от модели.
Ответы. Выход обычно стоит в 3–6 раз дороже входа, и он дорожает так же. Видимый ответ на узбекском в 1,7–1,8 раза дороже английского. Claude Haiku 5.5 без специальной настройки на узбекском чаще включала скрытые рассуждения, которые оплачиваются как выход, и с ними счет за ответ вырастал в 2,1–2,3 раза.
Одинаковый прайс, разные счета
Самый практичный результат исследования касается выбора модели. Claude Opus 5.5 и GPT-5.6 Sol продаются по одинаковой цене за токен. Но токенизатор Claude уже на английском тратит в 1,57 раза больше токенов, чем у OpenAI, а на узбекской латинице в 1,70 раза.
В деньгах это выглядит так. Обработка объема текста, который на английском занимает 1 млн слов (примерно десять романов), в узбекском переводе обойдётся на входе в $14,78 у Claude Opus 5.5 и в $8,70 у GPT-5.6 Sol. Расчёт сделан по официальным прайсам на 14 октября 2026 года.
Разброс между моделями при этом еще больше, чем надбавка за язык: тот же узбекский текст стоит от $0,37 у Claude Haiku 5.5 до $14,78 у Claude Opus 5.5. Поэтому сильнее всего на итоговые расходы влияет выбор модели, и проверять его нужно на собственных данных. Важная оговорка: это вывод о стоимости, а не о качестве ответов.
Где спрятаны лишние проценты
Часть надбавки зависит от того, как написан текст.
Кириллица и латиница. Соотношение зависит от модели: у Claude обе записи стоят одинаково, у других провайдеров разница составляет 7–23%. Если ваши тексты на кириллице, сравните модели на своих данных.
Апостроф. В буквах oʻ и gʻ его набирают четырьмя разными символами, и для токенизатора это разные знаки. Единообразное написание экономит до 5% токенов.
Системный промпт. На английском он занимает в 1,5–2 раза меньше токенов, чем на узбекском, а оплачивается в каждом запросе. Перед переходом стоит сравнить качество ответов.
Новый алфавит бюджет не изменит
С 22 апреля 2027 года вступает в силу новый узбекский алфавит: вместо oʻ, gʻ, sh и ch будут писаться ö, ğ, ş и ç. Пересматривать бюджеты на ИИ из-за него не придётся. Gorgona заменила буквы во всех текстах исследования: у Claude, Gemini и Qwen число токенов сократилось на 2–4%, у OpenAI и DeepSeek практически не изменилось. Заодно уйдут и лишние расходы из-за разнобоя с апострофом.
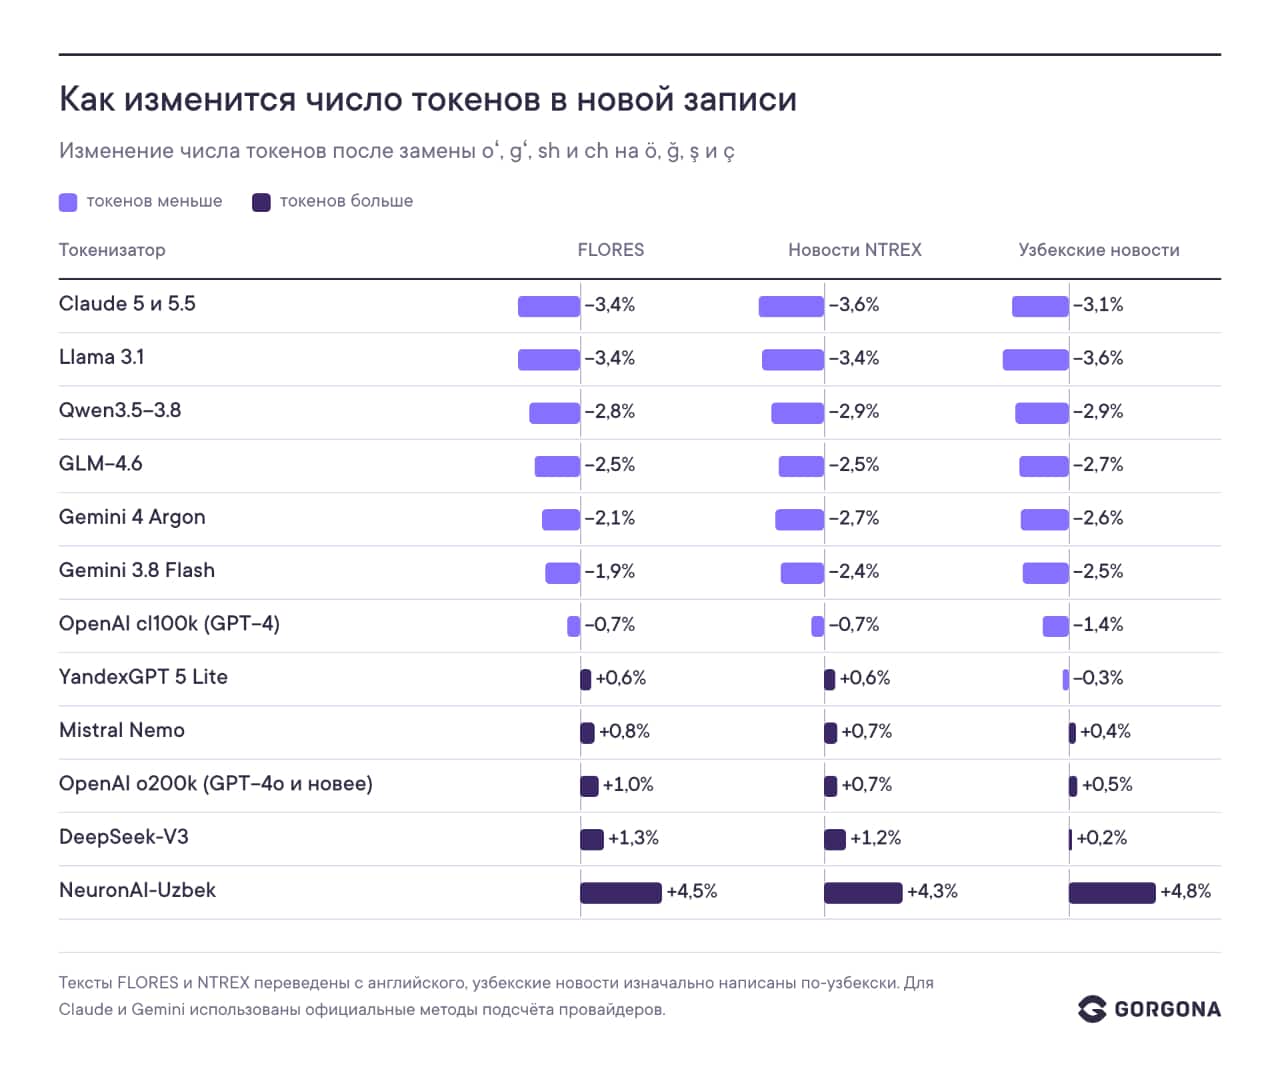
Тем, кто использует модели со специализированным словарём под узбекский, стоит заранее проверить их на текстах в новой записи.
Чек-лист для финансового директора
- Заложите надбавку за узбекский в бюджет, причём и на входящих токенах, и на исходящих;
- Сравнивайте модели по цене своего текста, а не по цене за миллион токенов;
- Считайте токены официальными методами провайдера, а не через сторонние сервисы;
- Следите за расходом на рассуждения в поле usage и ограничивайте их там, где они не нужны;
- Перепроверяйте расходы при смене модели: новая версия может прийти с новым токенизатором;
- При развертывании моделей на своих серверах смотрите на словарь токенизатора. Словарь, в котором учтен узбекский, почти снимает надбавку и экономит вычислительные ресурсы.
Почему это вопрос инфраструктуры
Надбавка за узбекский определяется не числом его носителей, а тем, сколько узбекских текстов видели модели при обучении. Поэтому открытые узбекские корпуса работают как цифровая инфраструктура: чем их больше, тем дешевле и, вероятно, качественнее ИИ-сервисы на узбекском для всех, от стартапов до госорганов. Такая работа под силу только компаниям, университетам и государству вместе.
Полная версия исследования «Один смысл, разная цена. Сколько стоит узбекский язык для ИИ?» с методикой и данными по каждой модели доступна по ссылке.
