Sun’iy intellekt uchun 6 mlrd sözlik özbek tili bazasi yaratildi
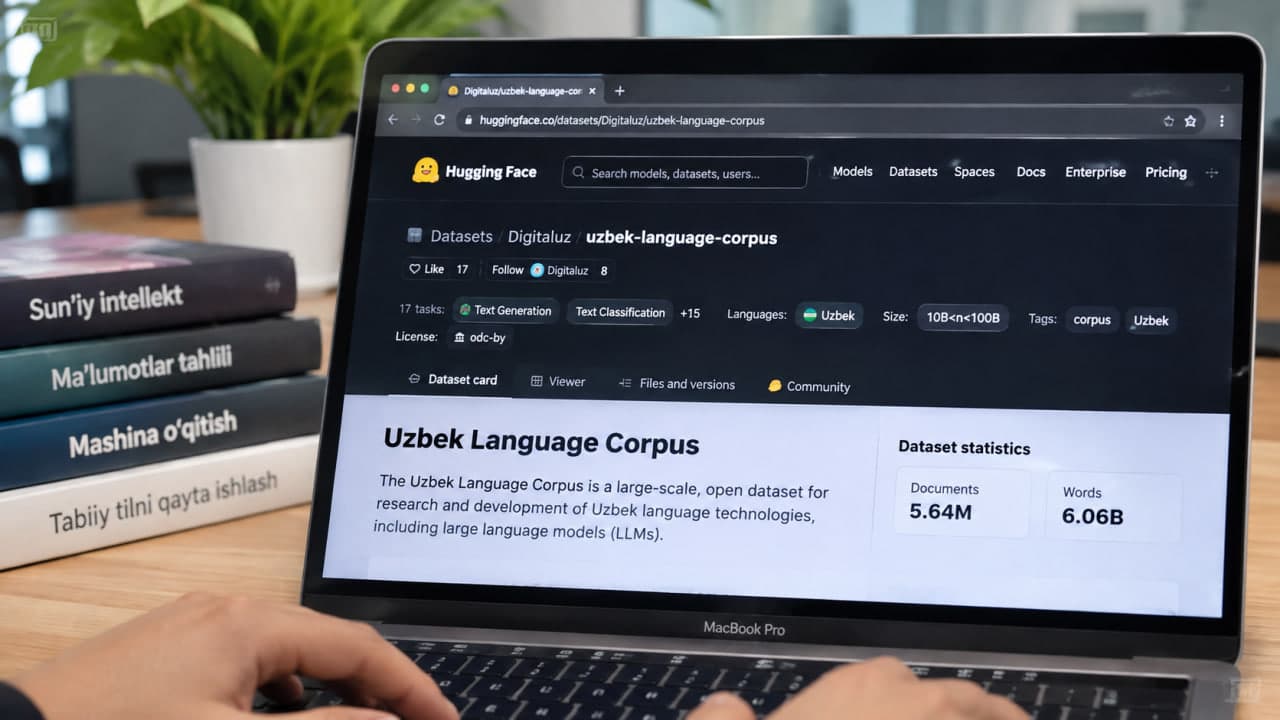
Özbek tilida işlaydigan sun’iy intellekt modellarini öqitiş va moslaştiriş uçun 6 mlrddan ortiq sözni qamrab olgan oçiq ma’lumotlar bazasi yaratildi. «Uzbek Language Corpus» Hugging Face platformasida erkin foydalaniş uçun joylaştirildi.
Korpusning 1.3-versiyasi 5,64 mln hujjat va 6,06 mlrd sözni öz içiga oladi. Ma’lumotlar 136 ta faylda saqlangan bölib, ularning umumiy hajmi 16,2 GBni taşkil etadi.
Bazaga kitoblar, qonunlar va Telegram postlari kiritildi
Korpusning asosiy qismini kitoblar, davriy naşrlar, arxiv hujjatlari va internet sahifalaridan olingan matnlar taşkil etadi. Milliy kutubxona materiallaridan 1,83 mlrd, «Tahrirçi» loyihasidan 1,28 mlrd, internet sahifalaridan esa 1 mlrddan ortiq söz jamlangan.
Şuningdek, bazaga Lex.uz’dagi 74,5 mingdan ortiq huquqiy hujjatlar, özbekça Vikipediyadagi 122,7 ming maqola va oçiq Telegram kanallaridagi 1,12 mln post kiritilgan. Ma’lumotlarning 52 foizi lotin, 46 foizi kirill, qolgan 2 foizi esa aralaş yozuvda.
Sun’iy intellekt özbek tilini yaxşiroq tuşunişi kerak
Yangi baza dasturçilar va tadqiqotçilarga katta til modellarini özbek tilidagi katta hajmdagi matnlar asosida öqitiş yoki mavjud modellarni mahalliy tilga moslaştiriş imkonini beradi. Undan Özbek tilida işlaydigan çat-botlar, matnlarni tahlil qiliş, huquqiy hujjatlarni qayta işlaş va boşqa sun’iy intellekt xizmatlarini yaratişda foydalaniş mumkin.
Avvalroq prezident Şavkat Mirziyoyev Raqamli texnologiyalar vazirligiga «Özbek tili korpusi»ni yaratiş vazifasini topşirgani haqida xabar berilgan edi. Korpusni yaratiş vazifasi prezidentning 2025-yil 22-oktabrdagi PF-189-son farmonida belgilangan. Raqamli texnologiyalar vazirligi korpusni yirik xalqaro til modellari işlab çiquvçilariga ham taqdim etmoqda.
